Om het gedachtegoed van Aslander te begrijpen, moeten we terug naar de tijd waarin digitale bestandsformaten hun intrede deden. ‘We hebben toen – onbewust – een verkeerde afslag genomen’, stelt Aslander. Informatie werd steeds vaker opgeslagen in bestanden die waren gekoppeld aan software van specifieke leveranciers. Zo ontstond volgens hem een vendor lock-in: gebruikers werden afhankelijk van die software om bij hun informatie te kunnen. ‘We hebben een soort stockholmsyndroom: we zijn verliefd geworden op onze gijzelaar Big Tech.’
Aslander: ‘Word- en PowerPoint-bestanden zijn niet ontwikkeld om analyses te maken of goed informatiemanagement toe te passen. Inmiddels hebben we te maken met een dataexplosie in allerlei verschillende bestandsformaten die elkaar niet ondersteunen. Kenniswerkers hebben geen idee meer wat waar staat. Wat we zijn gaan doen, is digitaliseren en niet informatiseren.’ Als voorbeeld noemt hij de Belastingdienst, die volgens hem met 900 systemen en dertig programmeertalen werkt. ‘Medewerkers zijn veel tijd kwijt aan zoeken, maar het vinden wordt steeds lastiger.’
Affaires
Aslander spreekt van een ‘malariamug’. ‘Je denkt dat het iets kleins is, maar mijn inzicht is dat informatie niet gevonden kan worden omdat ze in verkeerde formaten staat. Data is niet uniform in machinetaal uitleesbaar. Voor het aardbevingsdossier in Groningen zitten consultants mapjes open te klikken in talloze bestandssystemen om zo informatie te achterhalen. Maar zzp’er nummer één heeft werkelijk geen idee wat hij bij ‘dossier’ vier aantrof als hij al bij ‘dossier 40’ is. Laat staan dat hij op eenzelfde manier werkt als zijn collega’s. En we denken nu dat we dat met AI gaan oplossen. AI is een prachtige tool, maar voor nu is het niet veel meer dan een gokmachine.’ AI is volgens Aslander niet in staat om nauwkeurig en zorgvuldig om te gaan met grote hoeveelheden bestanden in een formaat dat is ontworpen voor printers. Aslander: ‘Onze data zit verspreid in talloze bakjes waar medewerkers slecht of niet bij kunnen of waar geen links tussen zitten. We leven in een netwerk- en informatiemaatschappij, maar die is niet zo ingericht dat we er goed mee kunnen werken.’
Aslander verbaast zich er ook over dat op scholen nauwelijks aandacht is voor hoe je met informatie om moet gaan. ‘Het menselijk brein denkt niet in mappen, submappen of inboxen, maar in verbanden tussen stukjes informatie en verbindingen daartussen.’ Zo zouden systemen ook ingericht moeten worden. ‘Omdat elke vraag in de kern een informatievraagstuk is.’
Ferrari’s
‘We zetten ICT verkeerd in’, doceert de techfilosoof. ‘Pc’s zijn Ferrari’s. Formule 1-wagens met een enorme power. Maar we zetten ze in als skelters. Mensen zitten nu werk te doen dat pc’s veel beter kunnen. Als je informatie machineleesbaar opslaat, kun je met AI en pc’s veel sneller en beter werken. Dat we dat niet hebben gedaan, is de malariamug. Klein, maar een ramp.’
Gelukkig is er een oplossing, maar eerst wil Aslander nog een misverstand de wereld uitruimen. Sinds DigiD verkocht dreigde te worden aan Amerikaanse tech, is er een trend ontstaan dat we data weer ‘soeverein’ willen houden: in eigen beheer. ‘Dat is mooi. Moet ook als je kijkt naar de Amerikaanse CLOUD Act’, zegt Aslander over de ongewilde macht van Big Tech om in onze informatie te kunnen kijken. ‘Maar wat we nu aan het doen zijn, is de verhuisdozen uit Amerika halen en onuitgepakt hier neerzetten. Dat kan soeverein zijn, maar daarmee heb je nog geen informatie-autonomie (iets kunnen met de data-red.). Normaal als je verhuist, open je dozen en ruim je op. Nu laten we alles gewoon in dozen zitten zonder de inhoud te kennen.’ Het heeft een ongewenst bijeffect. Aslander: ‘Stel ik heb een PowerPoint die ik deel met iemand. Dat is al dubbele opslag. Deelt die persoon het ook met vijftig anderen, dan wordt dat ook opgeslagen. Zo is er heel veel overbodige data. Veertien procent van alle data is bedrijfskritisch, 32% overbodig en 54 procent is “dark data”: data die nooit meer wordt geopend. Als we die “dozen” nu eerst eens gaan uitpakken, opruimen en goed opslaan, kan negentig procent van alle datapakhuizen dicht.’
Pleidooi
Aslanders pleidooi daarvoor in Informatieautonomie is om informatie zo op te slaan dat pc’s bestanden kunnen lezen en informatie als een menselijk brein weer samenvoegen en analyseren. Mensen kunnen programma’s als Word gewoon blijven gebruiken, maar andere bestandsformaten kiezen. In talen die machineuitleesbaar zijn. Denk aan bestandsextensies als .txt, .md, .html en .csv. Aslander: ‘Dan kun je wél betrouwbare en verifieerbare antwoorden op vragen krijgen.’ Ook oude/bestaande informatie is prima om te zetten naar machineleesbare informatie. Daar zijn tal van (gratis) tools voor. Als informatie eenmaal in het juiste opslagformaat staat, kun je met een uiterst simpel script (dat je met een AI-tool kunt maken) extreem robuust informatie uitlezen en analyseren. Hierdoor kun je bergen informatie moeiteloos doorgronden en er nieuwe informatieproducten van maken, zoals een website en een rapport. Dat was tot voor kort nagenoeg onmogelijk en nu een fluitje van een cent. Aslander: ‘We moeten van AI naar IA: van artificial intelligence naar informatiearchitectuur. Informatie zo vastleggen dat je er ook echt iets mee kunt.’ Een multi-agentic systeem stuurt gespecialiseerde assistenten tegelijk op dezelfde vraag af, elk met toegang tot echte bronnen, en laat ze elkaars bevindingen controleren. Aslander: ‘We kijken allemaal naar links (bestandsformaten van Big Tech), maar rechts ligt de oplossing. Verkeerde bestandsformaten zijn écht de bron van de meeste IT-ellende. Wie kiest voor open formaten, kiest niet alleen voor een betere informatiehuishouding, maar stopt met roeien richting een waterval.’
Pilot Informatie-autonomie
Aslander is initiatiefnemer bij de Pilot Informatieautonomie waarin hij met Belastingdienst, politie, UWV, veiligheidsregio’s, waterschappen en samen met een heel projectteam onderzoekt of het mogelijk is om met één à twee procent van de IT-kosten, tachtig procent van de functionaliteit van bestaande systemen te bereiken. En dan ook nog eens sneller, veiliger en duurzamer. Aslander: ‘We zijn telkens weer verbaasd hoe snel en goed dat gaat.’ De basis daarbij is dat ze informatie machineleesbaar maken en vervolgens met AI code en scripts maken om die informatie te analyseren. Aslander: ‘Dat is veel betrouwbaarder dan de AI zelf met de data te laten werken. Je gebruikt mens, AI en pc op de juiste manier. De mens verzint de scripts en laat AI en pc’s vervolgens het werk doen. De Engelse overheid is al een stuk verder dan de Nederlandse. In het VK wordt informatie wel in machineleesbare taal opgeslagen. Probleem in Nederland is ook dat CIO’s en CEO’s een totaal andere taal spreken, waardoor oplossingen buiten beeld raken. Met dit boek probeer ik een beweging te veroorzaken. Een omslag in denken voor de IT-wereld die jaarlijks miljarden kan opleveren.’
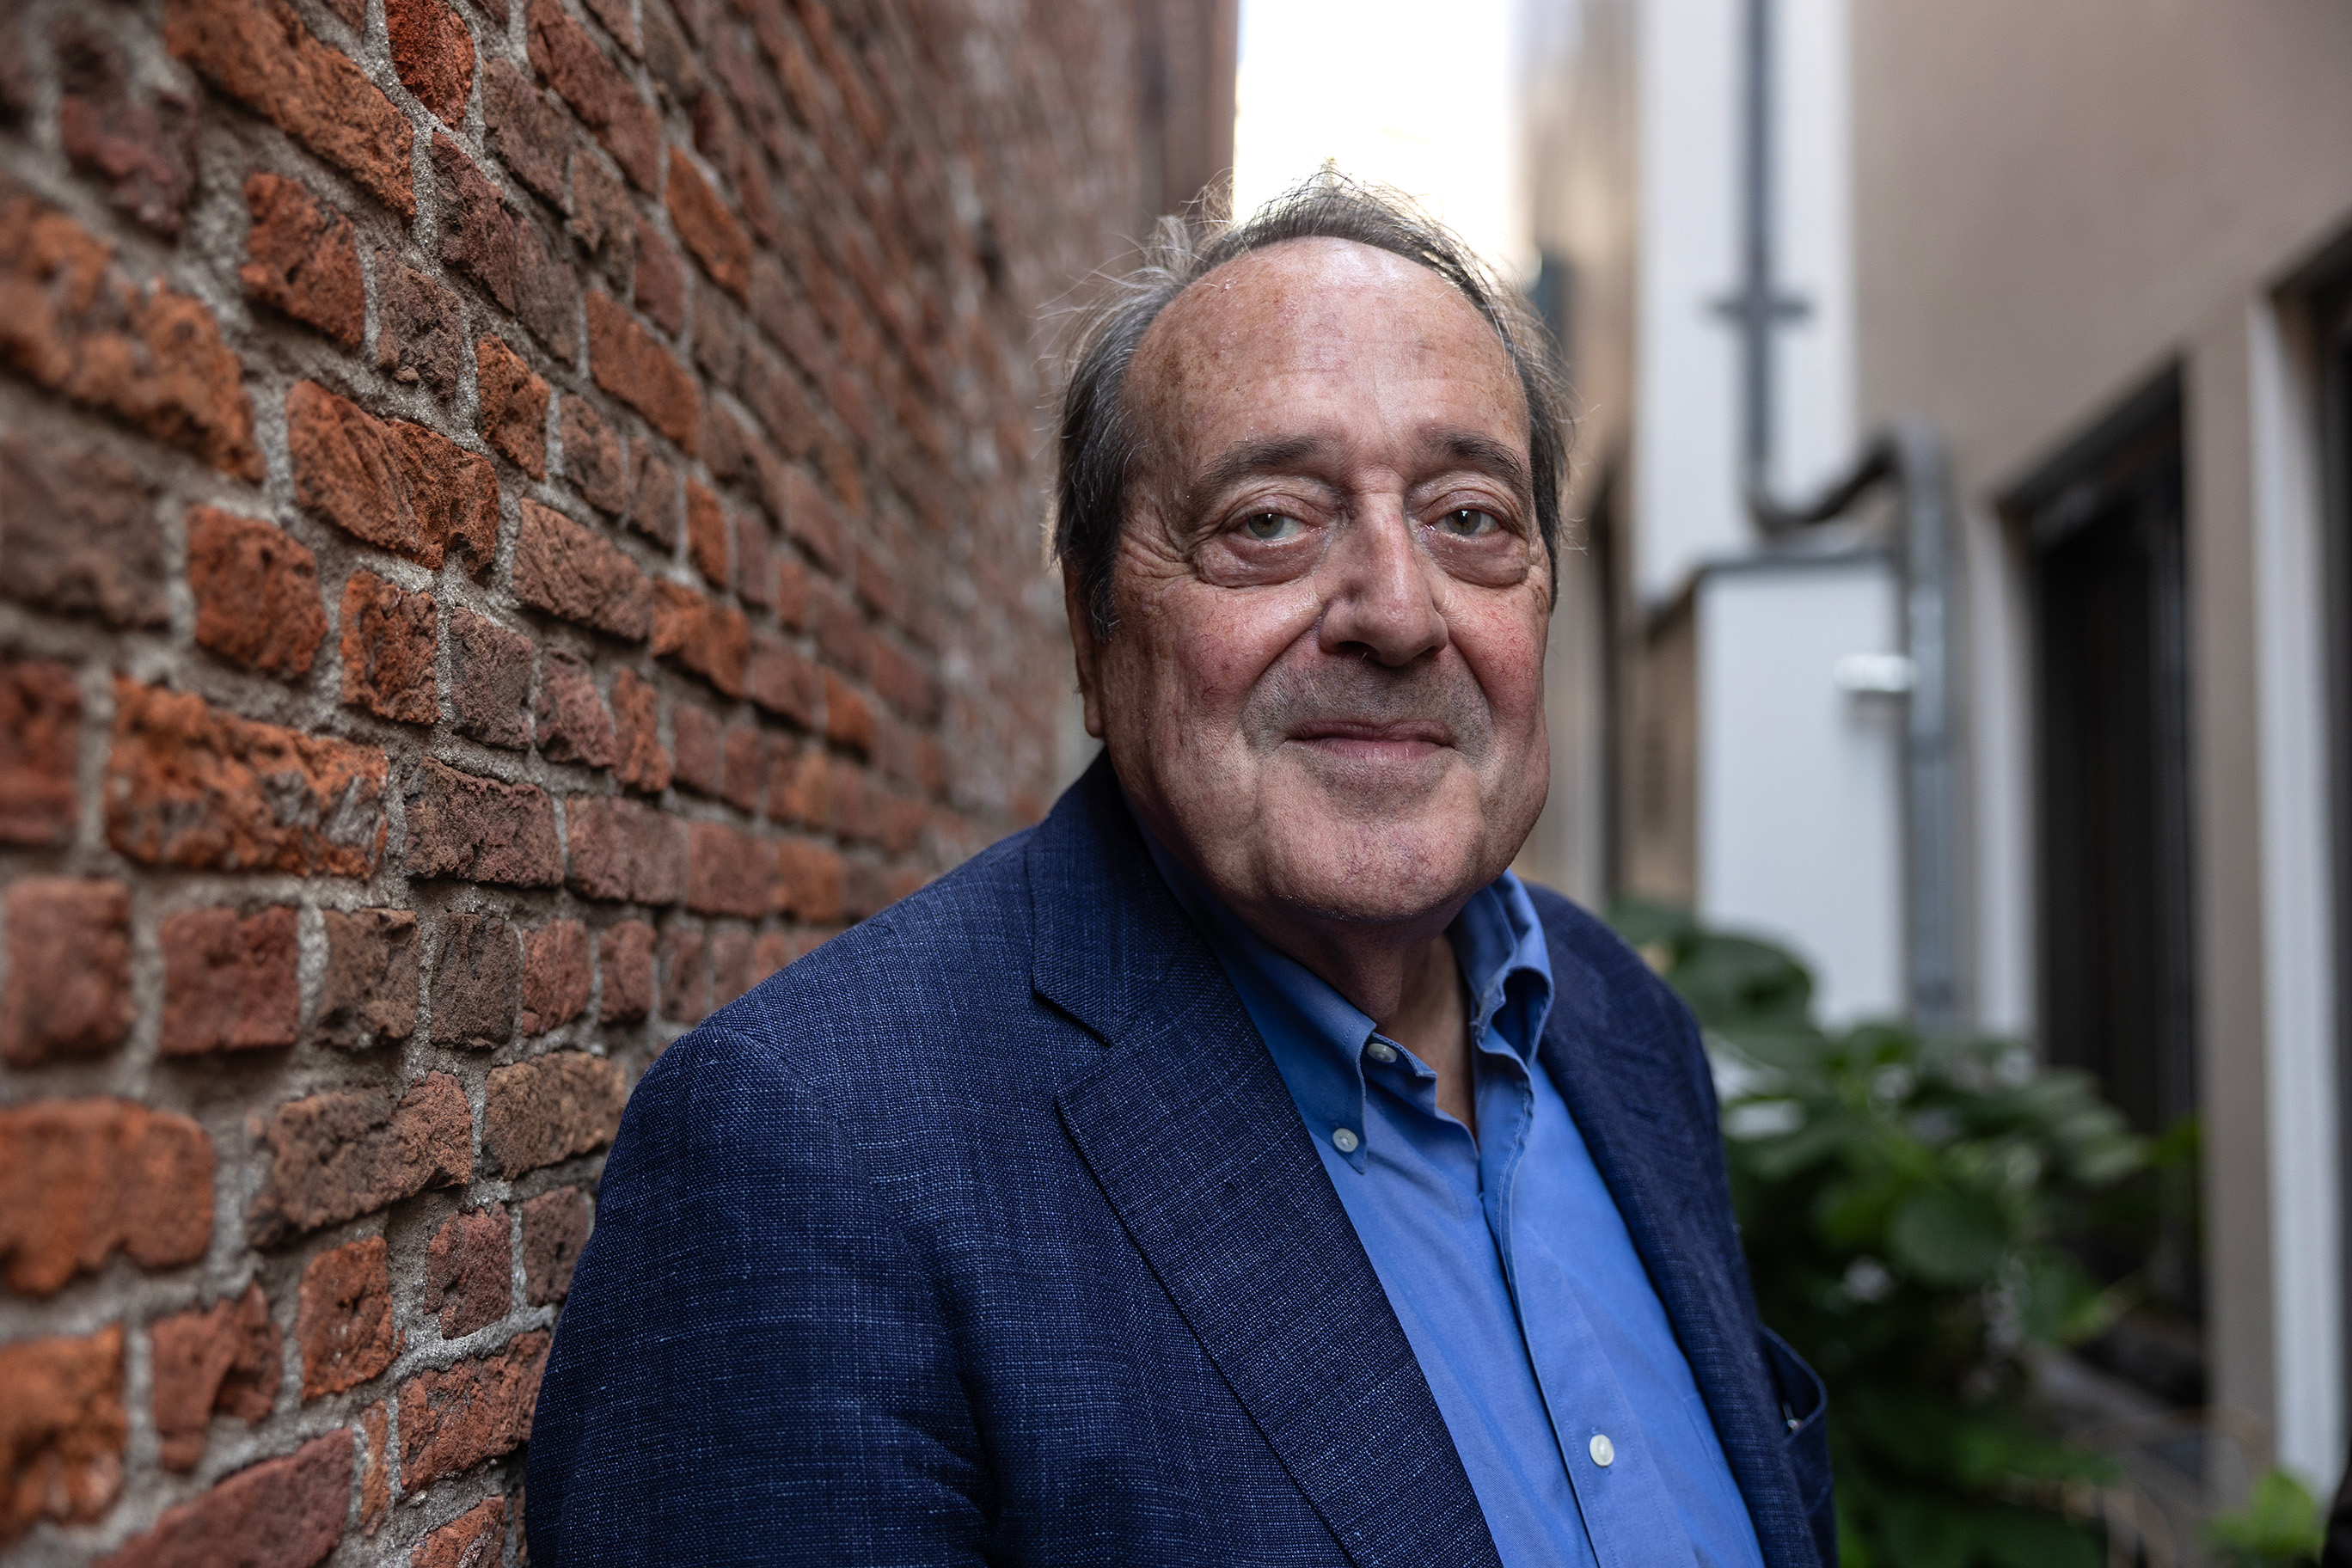
Fons Trompenaars: ‘Informatie moet chefsache zijn’
Hollandse meester in management, Fons Trompenaars, is warm pleitbezorger voor het gedachtegoed van Aslander. Hij schreef het voorwoord van de Engelse vertaling. Trompenaars haalt Peter Drucker aan, die zegt dat kenniswerkers zichzelf moeten kunnen sturen. Maar zelfsturing is niet alleen een kwestie van karakter. Zelfsturing vereist toegang tot informatie. Het vereist de mogelijkheid om te zoeken, te verbinden, te vergelijken, terug te vinden, te hergebruiken en voort te bouwen op wat men weet en wat de organisatie al weet.
Wanneer het formaat dit verhindert, zoals Aslander betoogt, wordt de medewerker gevraagd zelfsturend te zijn terwijl hem structureel de toegang tot de informatie die hij nodig heeft voor zelfsturing wordt ontzegd. Decennialang hebben we gesproken over de kennismedewerker, de lerende organisatie, digitale transformatie, informatie-overload, burn-out, samenwerking, autonomie en kunstmatige intelligentie alsof het afzonderlijke onderwerpen waren. We hebben er afdelingen omheen gebouwd. We hebben er interventies voor ontworpen. We hebben ze behandeld als psychologische, culturele, managerial of technologische uitdagingen.
Maar Martijn Aslander stelt een ongemakkelijkere vraag: wat als veel van deze problemen een gemeenschappelijke bron hebben? Wat als het medium waarin kennis/informatie wordt opgeslagen geen neutrale container is? Voor de kennismedewerker is het kantoor primair een informatieomgeving, maar hij kan niet bij die informatie. Het bestandsformaat bepaalt wie kan lezen, wie kan zoeken, wie kan verbinden, wie kan beslissen, wie moet compenseren en wie afhankelijk wordt. Organisaties racen om AI in te zetten bovenop informatiearchitecturen die nooit zijn ontworpen om door machines te worden gelezen, verbonden of beredeneerd. Ze willen autonomie terwijl ze het medium in stand houden dat die autonomie wegnam. CEO’s zouden veel meer aandacht voor dit vraagstuk moeten hebben. Trompenaars: ‘Het is chefsache. We hebben veel data, maar geen informatie. Als je niet de juiste vragen stelt, krijg je ook niet de juiste antwoorden.’